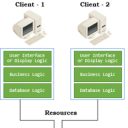
개념레이어드 아키텍처 패턴(Layered architectural pattern)은 소프트웨어 시스템을 여러 개의 논리적인 계층(Layer)으로 분리하여 구성하는 방식입니다. 각 계층은 특정 수준의 추상화된 서브 기능을 담당하며, 상위 계층에 서비스를 제공하도록 설계됩니다. 이는 관심사의 분리(Separation of Concerns) 원칙을 효과적으로 구현하여, 시스템의 복잡성을 관리하고 유연성을 높이는 데 기여합니다. 주로 PC 애플리케이션이나 아마존, 알리익스프레스와 같은 쇼핑몰(이커머스) 웹사이트 등 복잡한 비즈니스 로직과 데이터 처리가 요구되는 시스템에서 널리 활용됩니다. 구조 및 주요 계층일반적으로 정보 시스템은 다음과 같이 4단계의 계층으로 구성되는 경우가 많습니다. 각 계층은 바로 아래 계층에만 의존하며, 직접적으로 하위의 하위 계층과 통신하지 않는 것이 원칙입니다. - 프레젠테이션 계층 (Presentation Layer / UI Layer)
- 사용자 인터페이스(User Interface, UI)를 담당하며, 사용자의 요청을 받아 상위 계층으로 전달하고, 처리 결과를 사용자에게 시각적으로 보여주는 역할을 합니다. 웹 페이지, 데스크톱 애플리케이션의 GUI 등이 여기에 해당합니다.
- 예시: 웹 브라우저의 HTML/CSS/JavaScript, 안드로이드/iOS 앱의 화면 구성, 데스크톱 애플리케이션의 폼(Form).
- 애플리케이션 계층 (Application Layer / Service Layer)
- 프레젠테이션 계층과 비즈니스 로직 계층 사이에서 중개자 역할을 수행합니다. 특정 비즈니스 흐름(Workflow)을 정의하고, 여러 비즈니스 로직을 조합하여 프레젠테이션 계층이 요청한 작업을 수행합니다. 자체적인 비즈니스 규칙을 포함하기보다는 비즈니스 로직 계층의 기능을 호출하여 조율하는 역할을 주로 합니다.
- 예시: 사용자 로그인 처리, 상품 주문 프로세스 조율, 결제 흐름 관리.
- 비즈니스 로직 계층 (Business Logic Layer / Domain Layer)
- 애플리케이션의 핵심 비즈니스 규칙과 도메인 모델을 포함하는 계층입니다. 애플리케이션의 "뇌"와 같은 역할을 하며, 데이터의 유효성 검사, 계산, 특정 업무 규칙 적용 등 핵심적인 비즈니스 기능이 구현됩니다. 데이터 접근 계층에서 가져온 데이터를 가공하거나 저장하기 전의 로직을 처리합니다.
- 예시: 재고 확인, 할인 정책 적용, 사용자 권한 검증, 은행 거래 로직.
- 데이터 접근 계층 (Data Access Layer / Persistence Layer)
- 데이터 저장소(데이터베이스, 파일 시스템, 외부 서비스 등)에 접근하고 데이터를 영속화하는(저장 및 조회) 역할을 담당합니다. 상위 계층으로부터 데이터 요청을 받아 저장소와 통신하며, 저장소의 세부적인 구현 방식(SQL 쿼리, ORM 사용 등)을 상위 계층으로부터 추상화하여 감춥니다.
- 예시: 데이터베이스에 사용자 정보 저장/조회, 파일에서 설정 정보 읽기, 외부 API를 통해 데이터 가져오기.

적용 사례- 일반적인 데스크톱 애플리케이션 (General desktop applications): 복잡한 로직과 사용자 인터페이스를 가진 오피스 프로그램, 그래픽 디자인 툴 등.
- 이커머스 웹 애플리케이션 (E-commerce web applications): 아마존닷컴, 알리익스프레스와 같은 온라인 쇼핑몰. (상품 조회, 장바구니, 주문, 결제 등)
- 기업용 정보 시스템 (Enterprise Information Systems): ERP(전사적 자원 관리), CRM(고객 관계 관리), SCM(공급망 관리) 등 대규모 시스템.
- 은행 및 금융 시스템: 보안과 안정성이 중요하며 복잡한 거래 로직을 처리해야 하는 시스템.
장점- 관심사의 분리 (Separation of Concerns): 각 계층이 명확한 역할과 책임을 가지므로, 코드의 가독성이 높아지고 특정 기능에 대한 수정이 용이해집니다.
- 모듈성 및 재사용성 (Modularity and Reusability): 하위 계층은 상위 계층에 독립적이며, 여러 상위 계층에서 재사용될 수 있습니다. 예를 들어, 데이터 접근 계층은 다양한 비즈니스 로직에서 활용될 수 있습니다.
- 유지보수성 및 테스트 용이성 (Maintainability and Testability): 계층 간의 느슨한 결합(Loose Coupling) 덕분에 한 계층의 변경이 다른 계층에 미치는 영향을 최소화합니다. 각 계층을 독립적으로 테스트할 수 있어 디버깅 및 유지보수가 효율적입니다.
- 확장성 (Scalability): 시스템의 특정 부분이 병목 현상을 일으킬 때, 해당 계층만 독립적으로 확장하거나 최적화하기 용이합니다. 예를 들어, 사용자 트래픽 증가 시 프레젠테이션 계층만 서버를 추가하여 확장할 수 있습니다.
- 표준화 용이 (Easy Standardization): 각 계층의 역할을 정의하고 표준화하기 쉽습니다. 이는 대규모 팀에서 협업할 때 일관된 개발을 가능하게 합니다.
단점- 복잡성 (Complexity): 소규모 또는 단순한 애플리케이션의 경우, 여러 계층을 도입하는 것이 오히려 불필요한 복잡성을 증가시키고 초기 개발 시간을 늘릴 수 있습니다. 특정 상황에서는 특정 계층이 불필요할 수도 있습니다.
- 성능 오버헤드 (Performance Overhead): 요청이 여러 계층을 통과해야 하므로, 계층 간의 호출로 인한 약간의 성능 저하가 발생할 수 있습니다. 각 계층의 추상화 및 캡슐화 비용이 따를 수 있습니다.
- 경직성 (Rigidity) 및 추상화 누수 (Leaky Abstraction): 계층 간의 엄격한 규칙을 지키기 어렵거나, 때로는 하위 계층의 세부 구현이 상위 계층으로 노출되는 '추상화 누수'가 발생할 수 있습니다. 이는 계층 구조의 장점을 해치고 코드의 의존성을 높일 수 있습니다.
- 광범위한 적용의 어려움: 모든 종류의 시스템에 이 패턴이 최적이지 않을 수 있습니다. 특히 실시간 처리가 중요하거나 매우 단순한 애플리케이션에는 과도한 구조가 될 수 있습니다.
|